Robots.txt : un seul réglage contre l’entraînement des IA
Le 30 octobre 2026, Google, Microsoft, OpenAI et Anthropic annoncent un signal commun dans robots.txt pour l’entraînement des IA. Ce qu’il change pour une PME.
Depuis le 30 octobre 2026, Google, Microsoft, OpenAI et Anthropic ont annoncé qu’ils respecteront un même réglage dans le fichier robots.txt pour savoir si vos pages peuvent servir à entraîner leurs IA, et refuser ne vous retire ni de Google ni de Bing. Jusqu’ici, il fallait écrire une règle par éditeur d’IA, chacun avec son propre nom de robot. Le nouveau signal n’est pas encore un standard et n’est appliqué presque nulle part pour l’instant. Voici ce qui a été annoncé, ce que dit la règle, et ce qu’une PME marocaine peut décider dès maintenant.
Ce qui a été annoncé le 30 octobre 2026
Quatre annonces sont parues le même jour :
- Google, dans un billet de John Mueller sur le blog Google Search Central, « prévoit d’adopter volontairement » une proposition discutée à l’IETF, l’organisme qui rédige les standards techniques d’Internet.
- Microsoft, sur le blog de Bing, annonce une préférence commune pour l’entraînement dans robots.txt, complétée par des réglages page par page.
- OpenAI annonce qu’elle respectera ce signal commun et vise une mise en place dans les prochains mois. Ses réglages actuels dans robots.txt restent valables.
- Anthropic : Kevin Kelley, d’Anthropic, est l’auteur du texte proposé. Dans son message à la liste de discussion de l’IETF, il indique qu’Anthropic a déjà commencé à le mettre en place, et que l’extension à tous ses services prendra du temps.
Le texte s’appelle draft-kelley-aipref-training-preference-signal-00. C’est un brouillon individuel, publié le 30 octobre 2026 : la page de l’IETF précise qu’il n’est pas approuvé par l’IETF et n’a aucune valeur officielle. Google écrit qu’il continuera à l’affiner avec les autres acteurs au sein du groupe de travail AIPREF.
« Entraînement » a ici un sens précis. Le brouillon reprend la définition de ce groupe de travail : utiliser un contenu pour modifier les paramètres appris d’un modèle d’IA générative. Les modèles qui servent seulement à classer, trier ou noter ne sont pas concernés.
La règle, en pratique
Pour refuser l’entraînement sur tout le site, on ajoute ce groupe au fichier robots.txt :
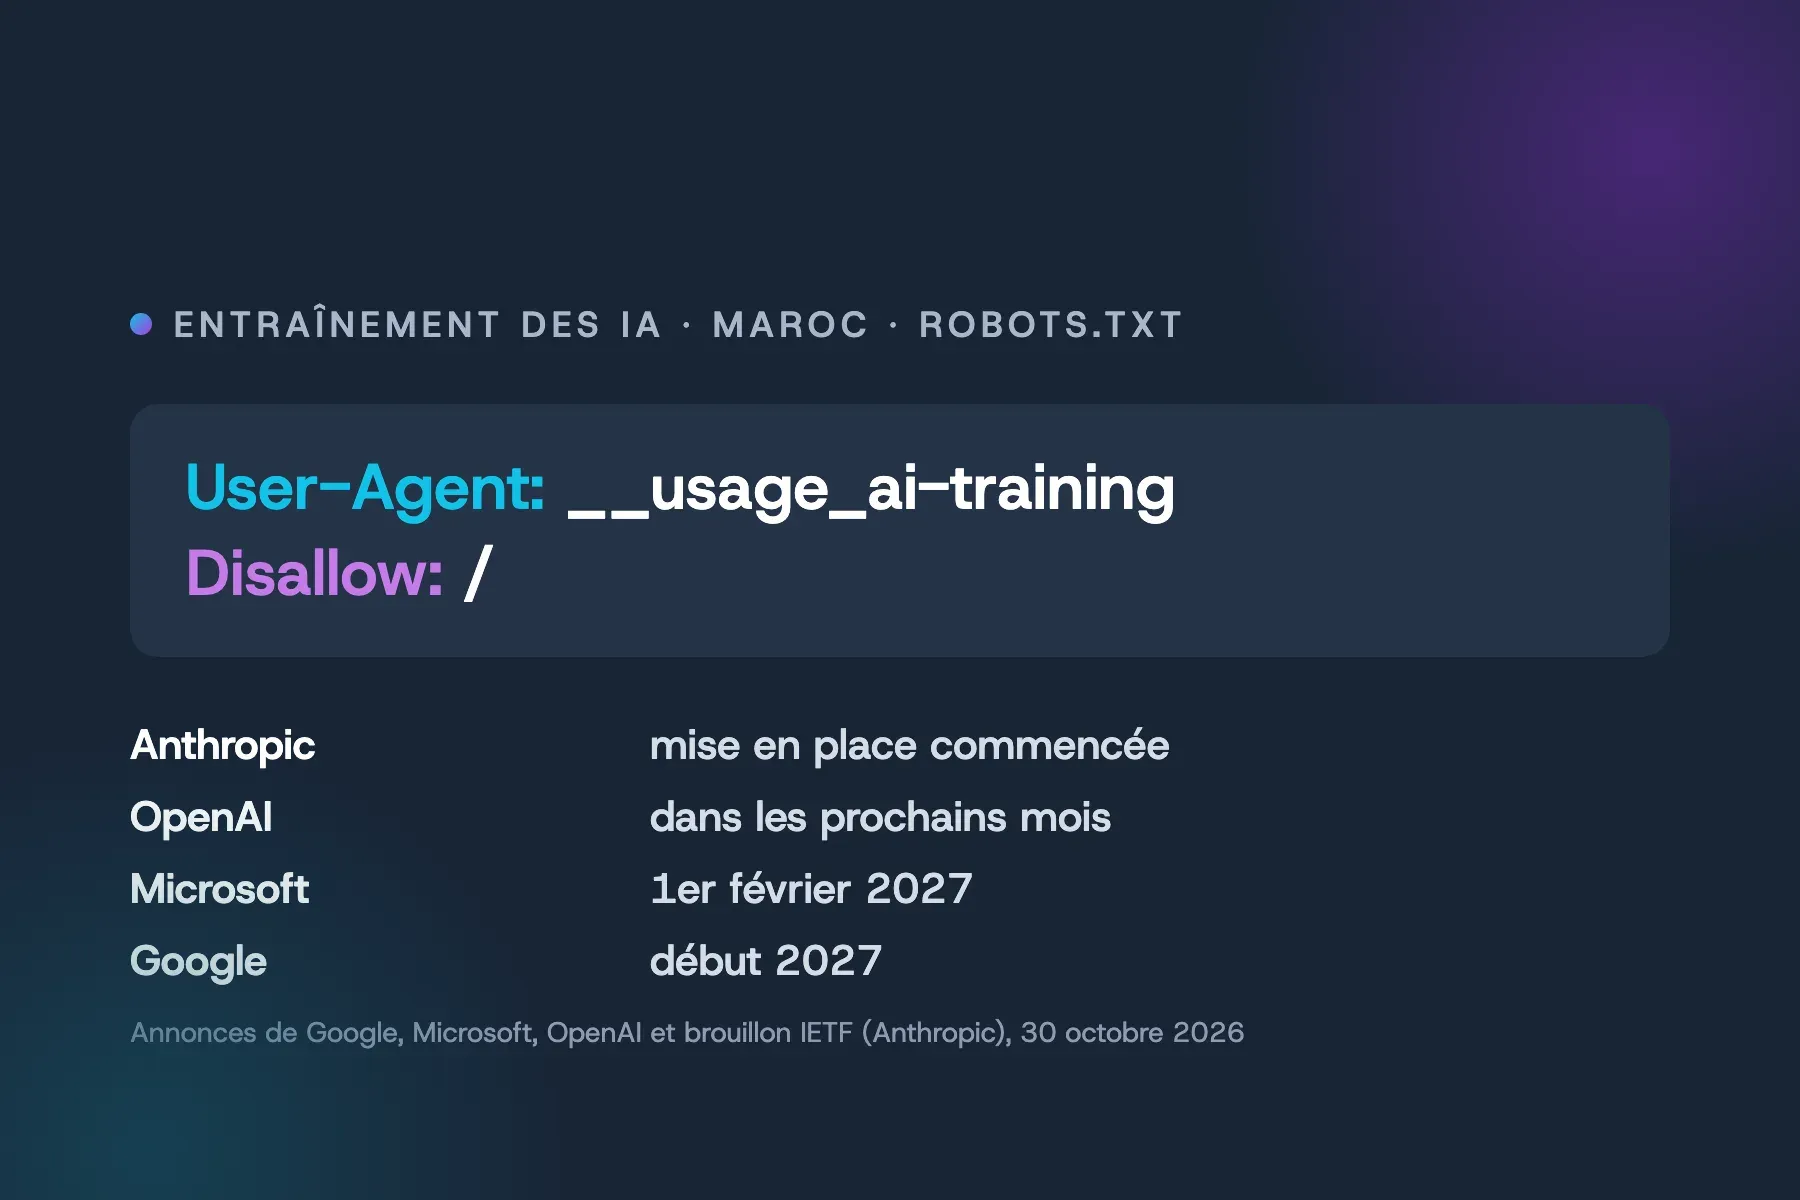
User-Agent: __usage_ai-training
Disallow: /
__usage_ai-training n’est pas le nom d’un robot. Le brouillon parle de « jeton de politique » (policy token) : il exprime une préférence sur l’usage des pages, pas sur leur visite. On peut aussi faire des exceptions. Sur le modèle de l’exemple du brouillon, ce groupe refuse l’entraînement partout sauf dans le dossier /presse/ :
User-Agent: __usage_ai-training
Disallow: /
Allow: /presse/
Quatre points du brouillon à connaître :
- Ce n’est pas un blocage. Le texte précise que ce jeton n’est pas une consigne d’exploration. Les règles écrites pour Googlebot ou Bingbot continuent de décider quelles pages sont visitées. Un robot d’IA « peut » simplement s’abstenir de télécharger ce qu’il n’a pas le droit d’utiliser.
User-agent: *ne compte pas. Une règle générale n’est jamais lue comme une préférence d’entraînement. Un fichier robots.txt sans ce groupe n’exprime donc aucune préférence, ni pour ni contre.- Les réglages de chaque éditeur restent valables, comme Google-Extended chez Google. Quand deux règles se contredisent, le brouillon recommande que la plus précise l’emporte, et laisse chaque éditeur documenter la sienne.
- Rien sur le passé. Le brouillon retient la préférence en vigueur au moment où la page a été récupérée. Il ne dit rien des contenus déjà collectés ni des modèles déjà entraînés.
Qui l’appliquera, et quand
Au 3 novembre 2026, voici les engagements publiés :
- Anthropic : mise en place commencée, selon l’auteur du brouillon, sans date pour l’ensemble de ses services.
- OpenAI : « dans les prochains mois », sans date précise.
- Microsoft : prise en compte à partir du 1er février 2027, au fil de l’exploration des pages.
- Google : « début 2027 » selon sa documentation sur ses robots, « en 2027 » selon le billet de John Mueller.
Ajouter ces lignes aujourd’hui ne change donc presque rien tout de suite. C’est un réglage à préparer, pas une urgence.
Refuser l’entraînement ne vous retire pas de la recherche
C’est le point qui compte le plus pour une PME qui veut être trouvée.
Chez Google, un refus exprimé avec ce signal, sans règle Google-Extended dans le fichier, sera lu comme un refus de Google-Extended. La documentation de Google précise que Google-Extended n’a pas d’effet sur la présence d’un site dans la recherche Google et n’est pas un critère de classement. Il y a une nuance : Google écrit que les sites qui autorisent explicitement Google-Extended peuvent apparaître dans les réponses de l’application Gemini et y recevoir des clics. Or ce même réglage décide aussi si Gemini peut s’entraîner sur vos pages : avec Google-Extended, les deux vont ensemble. Le billet de Google ne dit rien des AI Overviews ni du mode IA de la recherche.
Chez Microsoft, l’entraînement et l’usage de vos pages dans les réponses de l’IA (le « grounding ») se règlent séparément. Le grounding se règle page par page, avec trois valeurs : autorisé (par défaut), limité aux services de Microsoft (AI Overview, AI Mode, Copilot, Microsoft 365), ou refusé. Par exemple, pour refuser :
<meta name="Bingbot" content="ai-grounding:disallow">Microsoft indique que ces préférences ne changent pas l’accès aux résultats classiques de Bing, mais que les deux options restrictives réduisent fortement la visibilité dans les réponses générées par l’IA. Sans réglage publié, l’entraînement comme le grounding sont autorisés.
Si vos pages portent noarchive ou nocache, Microsoft les remplace par ces nouvelles préférences : après le 1er mars 2027, Bing ne les lira plus pour l’entraînement ni pour le grounding. Les sites concernés pourront enregistrer une préférence temporaire dans Bing Webmaster Tools à partir du 15 décembre 2026. Elle expirera au plus tard le 30 septembre 2027.
Que faire pour une PME marocaine
- Regardez votre fichier actuel. Ouvrez
votresite.ma/robots.txtdans un navigateur. Vérifiez qu’aucune ligneDisallow: /ne se trouve sousUser-agent: *: elle bloquerait tous les robots, moteurs de recherche compris. Le nouveau signal ne touche pas Googlebot ni Bingbot ; ne les bloquez pas par erreur en voulant bloquer les IA. - Décidez selon ce que vous publiez. Pour un site vitrine ou une boutique, l’enjeu principal est d’être trouvé et cité, et la question de l’entraînement pèse moins. Si votre valeur est dans le contenu lui-même (formations, guides payants, photos, bases de données), un refus a plus de sens.
- Notez les dates. Le 1er février 2027 chez Microsoft, début 2027 chez Google, et le 1er mars 2027 chez Bing si vos pages utilisent noarchive ou nocache.
- Sur WordPress, le fichier robots.txt est souvent produit par WordPress lui-même ou par une extension SEO. Modifiez-le depuis l’extension, ou demandez à la personne qui gère votre site.
Ce réglage fait partie de ce que nous vérifions dans un travail de référencement SEO et GEO : être trouvé sur Google et cité par les assistants d’IA, sans rien bloquer par erreur. Si vous publiez des textes écrits avec l’IA, lisez aussi ce que Google a précisé en octobre sur le contenu généré par IA. Pour faire vérifier votre fichier robots.txt et vos balises, parlons-en.
Sources
- Google Search Central, « Supporting a shared AI training control for websites », John Mueller, 30 octobre 2026.
- Google, documentation des robots d’exploration courants, section Google-Extended, consultée le 3 novembre 2026.
- Microsoft Bing, « Your content, your choice: clearer preferences for training and grounding », Krishna Madhavan, 30 octobre 2026.
- OpenAI, « Making it easier for websites to express AI training preferences », 30 octobre 2026.
- IETF, draft-kelley-aipref-training-preference-signal-00, Kevin Kelley (Anthropic), 30 octobre 2026.
- Kevin Kelley, message à la liste ai-control de l’IETF, 30 octobre 2026.
Article à jour au 3 novembre 2026.